
3万小时触觉数据补齐手感,新智具身联合复旦大学发布Neo系列:统一具身智能触觉方言
7月26日消息,上海新智具身智能科技有限公司(NeoteAI)联合复旦大学可信具身智能研究院,正式发布 Neo 系列三份技术报告,以超 3 万小时视觉-触觉交互数据构建触觉数据底座,并提出 Neo-VTLA 触觉预判模型和 Neo-TWAM 触觉世界模型两条技术路线。该系列工作将触觉从「辅助模态」跃升为具身智能的「核心基建」,为解决机器人跨越物理交互「最后一厘米」的行业难题提供了系统性方案。
Neo-Foundation:统一触觉「方言」,构建 3 万小时交互语料库
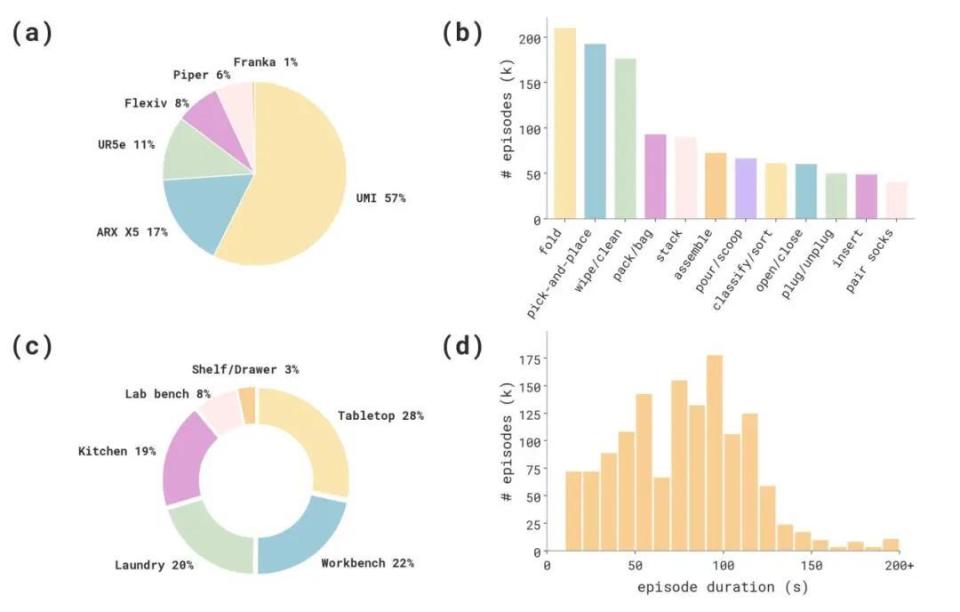
触觉数据的规模化应用长期受制于各类触觉设备输出格式互不兼容——不同传感器输出的凝胶形变图、电容矩阵或六维力向量,犹如缺乏统一语法的「方言」。NeoteAI 搭建的 NeoData 数据集包含:
超 3 万小时视觉-触觉交互视频
约 140 万条操作片段,33 亿个时间步
对应 80 亿帧 RGB 画面与 100 亿帧触觉图像
动用 Franka、Piper、UR5e 等 6 种机器人本体
覆盖 450 项真实长程任务,由 90 位操作员采集
已开源 5 千小时视觉-触觉交互视频
团队还提出 NeoForce 统一表征模型,无论底层传感器硬件如何,都能学习到具备迁移能力的「触觉普通话」——哪里被按、按多大力、有没有横向拉扯,有效解决了跨设备数据融合难题。
Neo-VTLA:用「触觉预判」替代「后视镜」感知
现有 VLA 模型在融合触觉信号时面临双重困境:触觉信号仅在接触瞬间产生高频响应,大部分时间处于「静默」状态,极易被海量视觉 Token 淹没;即使成功提取当前触觉特征,本质上仍是对已发生动作的滞后反馈。
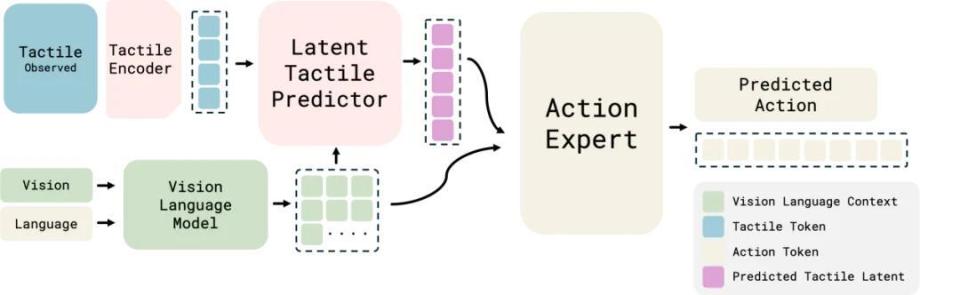
Neo-VTLA 提出全新方案:不依赖滞后的当前触觉,而是预测未来 50 步内的触觉演变。该模型将当前触觉编码为紧凑的潜在 Token,结合视觉上下文预判滑移、受力等趋势,指导动作模块提前调整。实测结果:插插头任务成功率达 85%(同类视觉方案仅 60%),拔钥匙任务成功率达 99%(视觉方案仅 35%)。
更为关键的是,Neo-VTLA 突破了传统模仿学习仅依赖专家成功轨迹的局限,让机器人从失败数据中自主进化。通过训练进度评估模型识别「退步」与「救场」等复杂行为,结合离线强化学习,使机器人在毛巾折叠、书包收纳、纸箱折叠等长程任务上的成功率分别从 50%、35%、20% 大幅跃升至 95%、80%、75%。
Neo-TWAM:在世界模型中重构「触觉想象」
如果说 Neo-VTLA 是加装预判雷达,Neo-TWAM 则是对机器人「认知中枢」的重构:它把触觉放进世界模型,让机器人在动手之前先在「想象」里完整推演一遍操作视角和手感。该模型采用混合专家架构,内置视频、触觉、动作三个异步专家网络,总参数量 72 亿,仅相当于全宽方案的一半。
实验结果表明,Neo-TWAM 仿真平均成功率达 84.5%(世界模型最强基线为 36%),真机 8 项任务平均成功率 46.3%(LingBot-VA 为 21.9%)。消融实验进一步证实,去除「未来触觉预测」或「当前触觉条件」均会导致性能显著下降,确立了触觉在世界模型中的不可或缺性。
触觉:具身智能的下一个 Scaling Law?
三份报告合起来释放了一个明确信号:Neo-Foundation 验证了触觉模态具备类似视觉的 Scaling 潜力;Neo-VTLA 证明了触觉可以自然接入现有 VLA 架构;Neo-TWAM 确立了触觉在世界模型顶层设计中的核心地位。机器人的认知范式正从单一的「视觉驱动」向「视触融合」演进——「看得见杯子不等于拿得稳,认得出插座不等于插得进」这一物理常识,终于被写入机器人的底层逻辑。项目数据和模型已开源(research.neoteai.com)。

